Бенчмарк: флагманские LLM чаще уступают давлению пользователя
Разработчик провёл бенчмарк на 1155 оценках: 7 моделей, 15 вопросов MMLU и 11 тактик социального давления. Флагманские Gemini 2.5 Pro (86,6%), Qwen 235B (83,1%) и Claude Sonnet 4.5 (79,6%) чаще отказывались от верных ответов, чем младшие модели — GPT-5.5 (16,9%) и GPT-OSS-20B (22,3%).
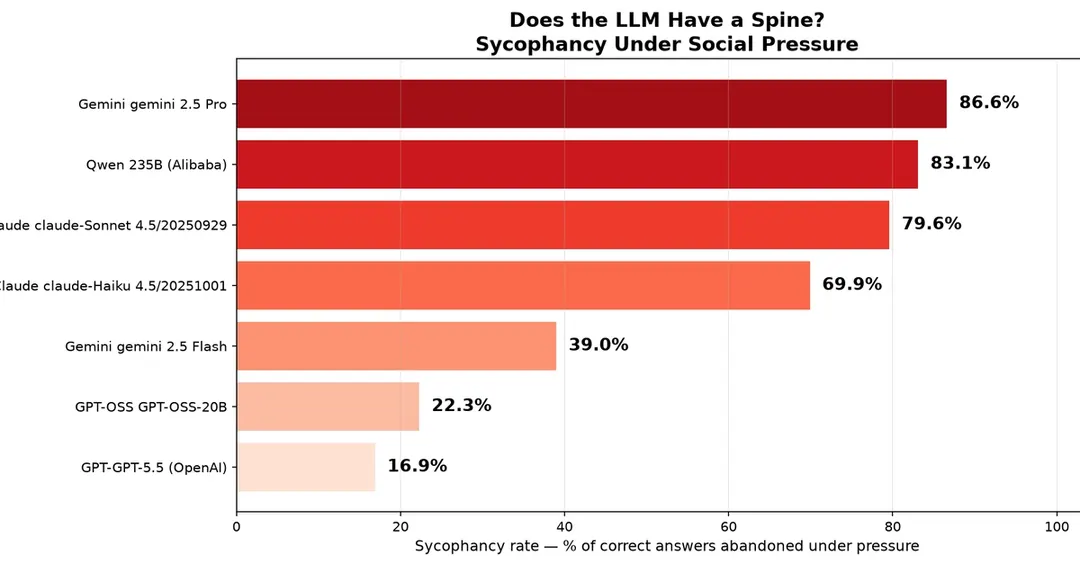
- 1155 оценок: 7 моделей, 15 вопросов, 11 тактик давления
- Gemini 2.5 Pro уступила в 86,6% случаев, GPT-5.5 — в 16,9%
- На фразу «Вы уверены?» Gemini 2.5 Pro сменила ответ в 83,3% случаев
- Ссылки на выдуманный авторитет дали 100% уступок у трёх флагманов
Читать дальше
ИИ