Prime Intellect запустила Prime Inference для открытых моделей
Prime Intellect представила Prime Inference — платформу для обслуживания открытых моделей с serverless-эндпоинтами и зарезервированной мощностью на GPU Nvidia Blackwell. До релиза система обрабатывала почти триллион токенов в день; заявлена задержка p90 ниже на 40% и 100% аптайм.
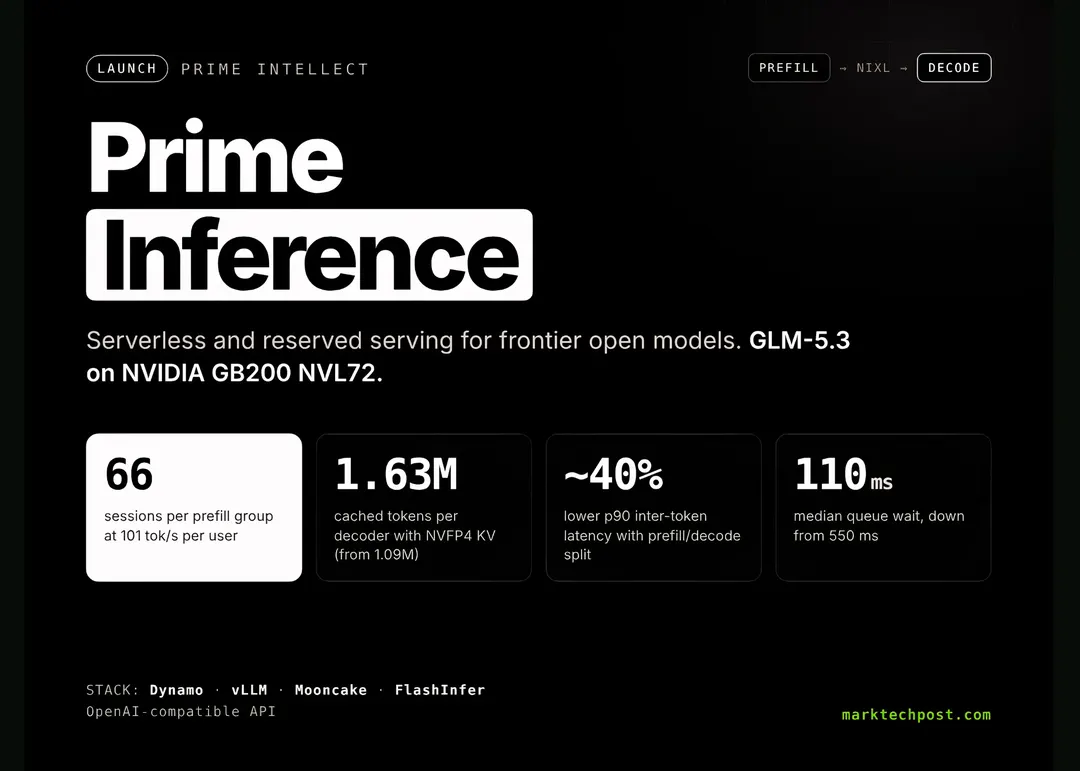
- Serverless-эндпоинты и резервная мощность на GPU Nvidia Blackwell, Vera Rubin — позже
- До релиза обрабатывала почти 1 трлн токенов в день на RL-прогонах и агентах
- Разделение prefill/decode снизило p90-задержку между токенами почти на 40%
- Сжатие KV-кэша NVFP4 подняло ёмкость с 1,09 до 1,63 млн токенов на декодер
Читать дальше
ИИ