Разбор Mellum2.1: реальные размеры GGUF и бенчмарки JetBrains
Автор проверил файлы модели JetBrains Mellum2.1-12B-A2.5B-Thinking-GGUF через API Hugging Face: рекомендованный Q4_K_M весит 8,07 ГБ, минимальный MXFP4_MOE — 7,03 ГБ. По собственным тестам JetBrains модель выигрывает в генерации кода, но уступает плотной Qwen3.5-9B в агентных бенчмарках.
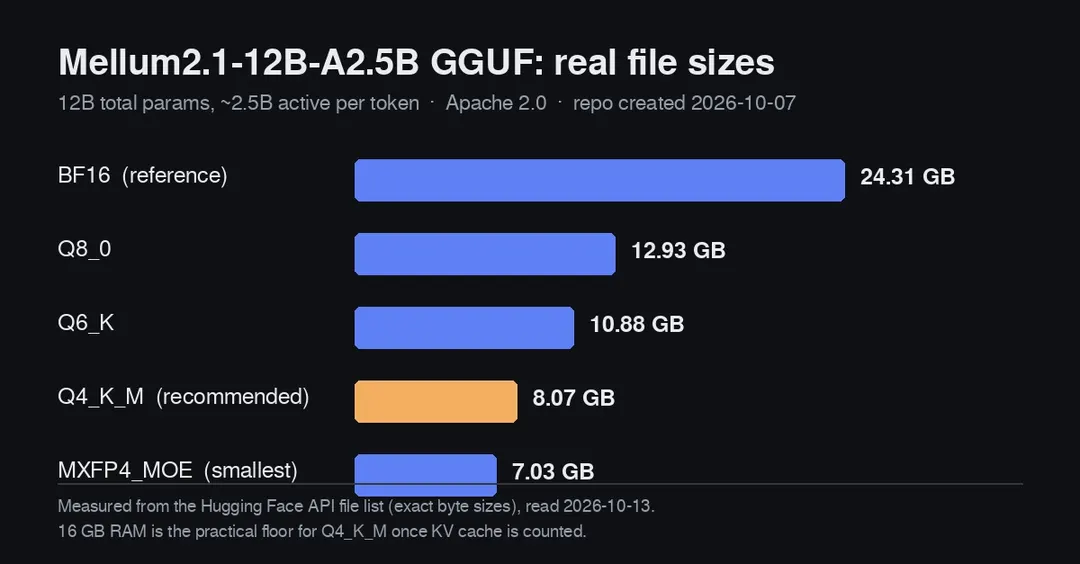
- Q4_K_M — 8,07 ГБ, MXFP4_MOE — 7,03 ГБ, BF16 — 24,31 ГБ
- Практический минимум — 16 ГБ ОЗУ, контекст 131k не влезет
- LiveCodeBench v6: 82,0% против 75,4% у Qwen3.5-9B
- SWE-bench Pro: 28,0% против 38,0% у Qwen3.5-9B
Читать дальше
ИИ