Ling-3.1-flash: гибрид 7:1 сокращает KV-кэш до 10,6 ГБ на 1M токенов
Вышедшая под лицензией MIT модель Ling-3.1-flash (560B параметров, 25B активных) использует 63 слоя линейного внимания KDA и лишь 9 слоёв MLA. По расчётам из config.json это даёт около 10,4 КБ кэша на токен — примерно 10,6 ГБ на последовательность в 1M токенов против 83 ГБ при полном латентном внимании.
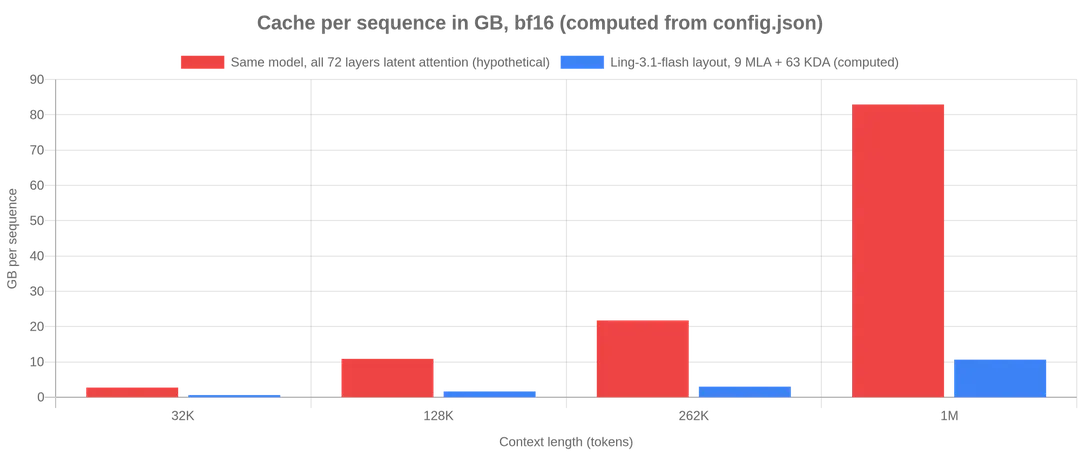
- 72 слоя: 63 KDA и 9 gated MLA, соотношение 7:1
- Кэш ~10,4 КБ на токен, ~10,6 ГБ на 1M токенов в bf16
- Веса FP8 занимают 573,8 ГБ в 54 шардах
- В конфиге max_position_embeddings 262 144, а не 1M
Читать дальше
ИИ