Meta раскрыла детали суперкластера Prometheus на гигаватт
Meta опубликовала технические детали ИИ-суперкластера Prometheus в Нью-Олбани (Огайо), который масштабируется примерно до 1 млн GPU. Первая фаза уже обучила модели семейства Muse, включая Muse Wonder; goodput превышает 85% на предобучении и 90% на RL, а наработка на сбой выросла с 47 до 54 тыс. GPU-часов.
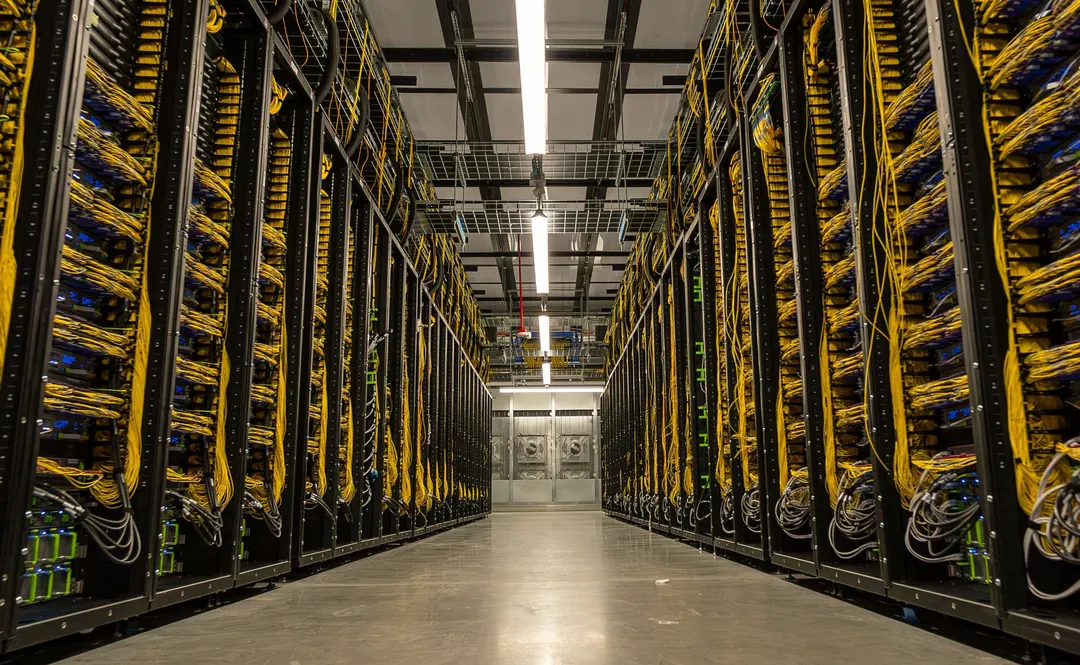
- Кластер использует GB200 NVL72 (Catalina), GB300 NVL72 (Clemente) и готовит Vera Rubin NVL72 (San Miguel)
- Catalina: 72 GPU, 13,4 ТБ HBM3e, 720 PFLOPS FP8, около 120 кВт на две стойки
- Clemente: 288 ГБ HBM3e на GPU, более 1 экзафлопса FP4, около 135 кВт на стойку
- Из каждых 72 GPU в работе 64, остальные восемь — резерв внутри стойки
Читать дальше
ИИ