Hugging Face: встроенные оценщики ИИ пока не решают проблему бенчмарков
Глава по политике Hugging Face Ирен Солаиман на TechCrunch Disrupt заявила, что бенчмарки ИИ остаются незрелой наукой: результаты трудно воспроизводить, а сравнивать тесты между собой почти невозможно. Встроенные сторонние оценщики моделей требуют стандартизации, а агентные оценки дороги и сложны.
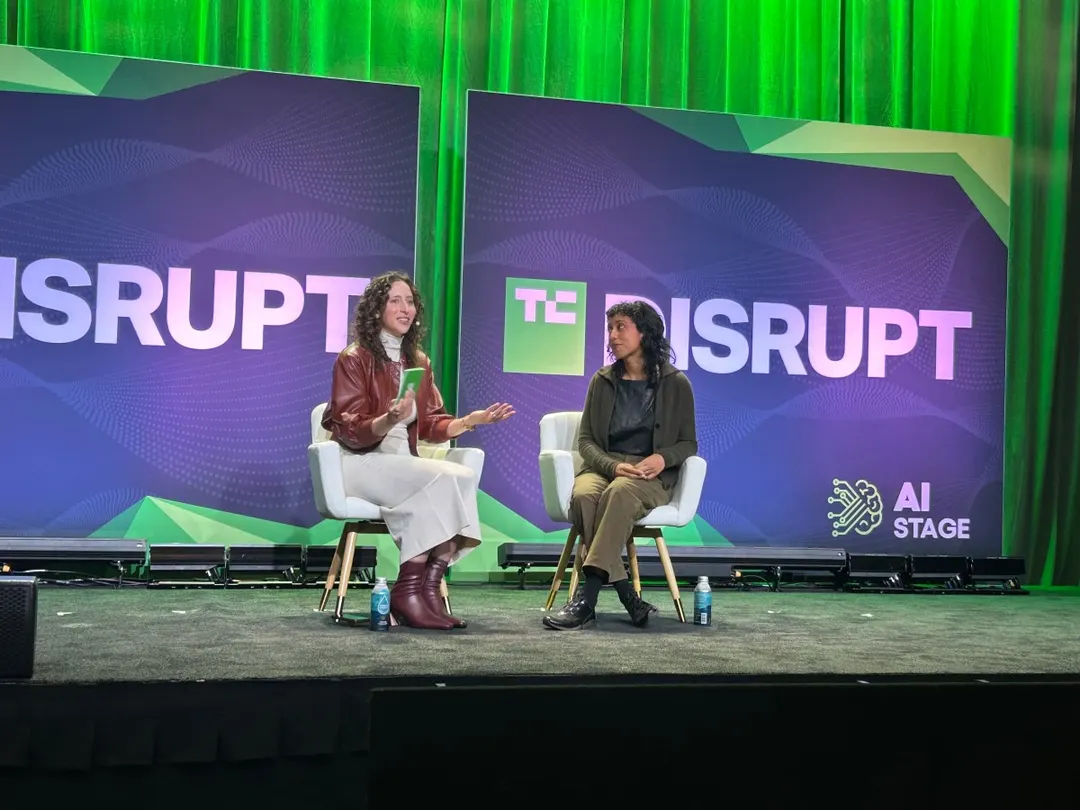
- Солаиман: воспроизводимость результатов — ключевой критерий доверия к бенчмаркам
- Тесты быстро устаревают, единого экосистемного стандарта оценки нет
- Оценки агентов дороги, а тестов для харнессов заметно меньше, чем для моделей
- Найм Accenture первым оценщиком Anthropic вызвал критику в отрасли
Читать дальше
ИИ