Nvidia выпустила открытую модель Nemotron 3.5 Bolt E4B для локальных ИИ-агентов
Nvidia представила открытую малую языковую модель Nemotron 3.5 Bolt E4B на 8 млрд параметров (4 млрд эффективных) с контекстом 64K. Она работает локально на RTX, Jetson и DGX Spark, занимая 3,1–4,3 ГБ VRAM в квантовании Q4_K_M, и предназначена для голосовых ассистентов, игровых NPC и роботов.
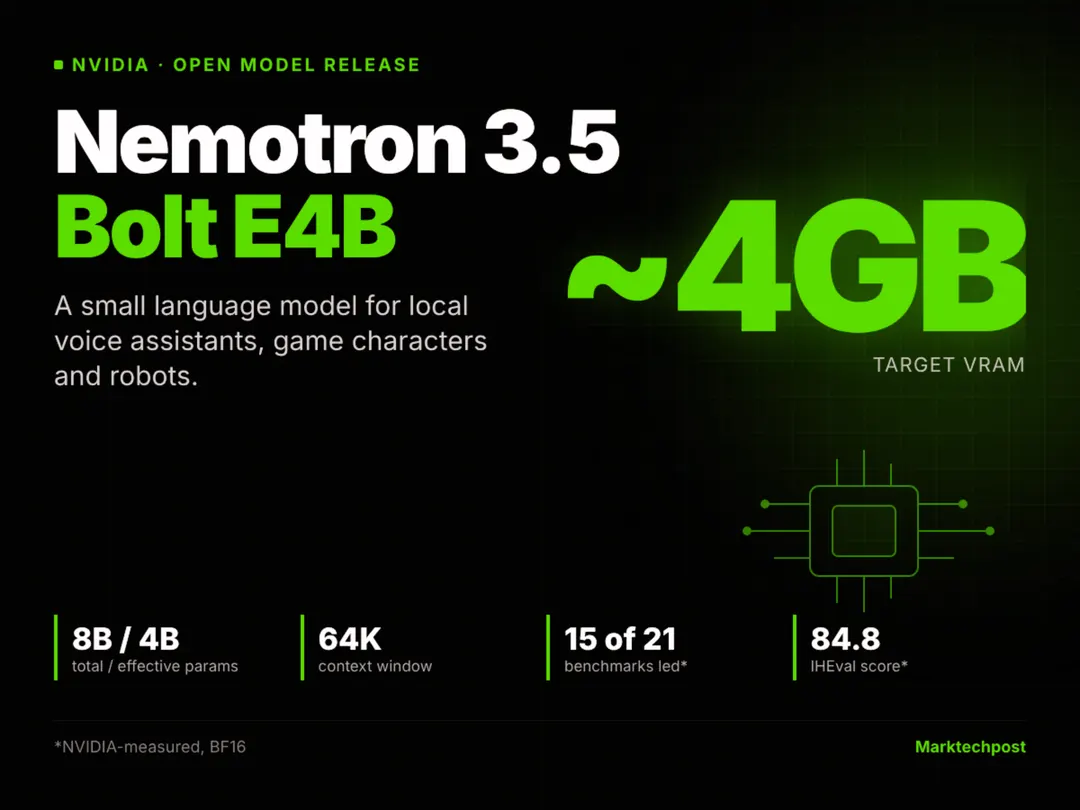
- 8 млрд параметров, 4 млрд эффективных, контекст 64K
- Q4_K_M занимает 3,1–4,3 ГБ VRAM на RTX
- Лидирует в 15 из 21 бенчмарка против Gemma 4 E4B и Qwen3.5-4B
- 272,6 токена/с с DFlash на RTX 5070 — в 1,21 раза быстрее Gemma
Читать дальше
ИИ