MIPU: оценка обновлений LLM по качеству инференса, а не по loss
MemoraX AI с Тяньцзиньским университетом и Alibaba представили на NeurIPS 2026 метод MIPU для RL-обучения LLM: обновление принимается, только если оно улучшает реальный инференс. На Qwen3-4B средняя точность выросла до 66,71% (+2,29 п.п. к GRPO), на Qwen3-1.7B — до 53,97% (+3,11 п.п.).
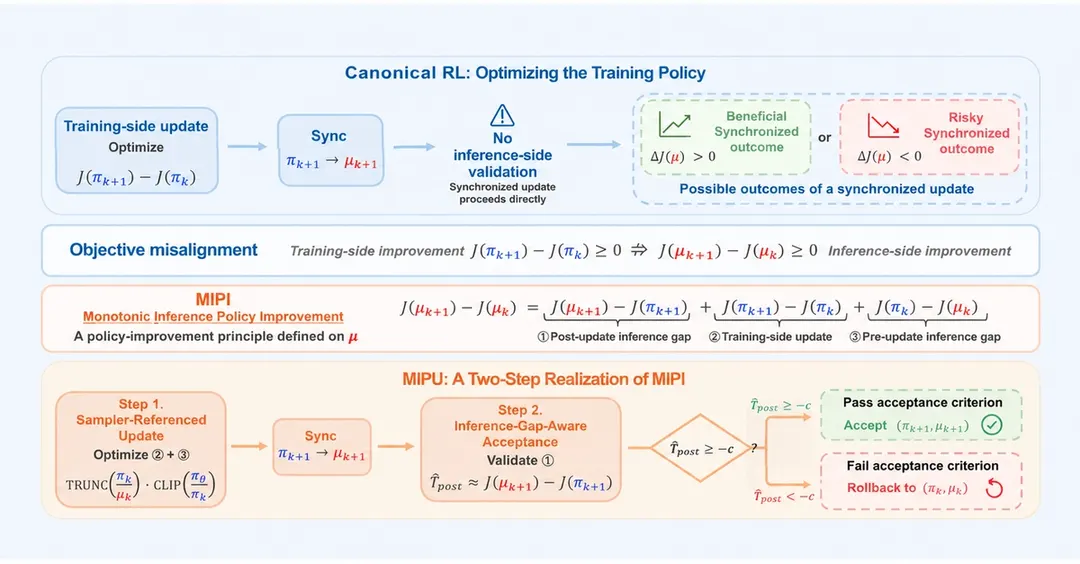
- MIPU даёт 66,71% на Qwen3-4B против 64,42% у GRPO
- На Qwen3-1.7B результат 53,97%, прирост 3,11 п.п.
- Метод отбирает обновления по поведению модели при инференсе
- Тесты шли на MATH-500, AIME24, OlympiadBench, Minerva и AMC23
Читать дальше
ИИ