Prime Intellect выпустила Prime Mega MoE с ускорением обучения MoE-моделей
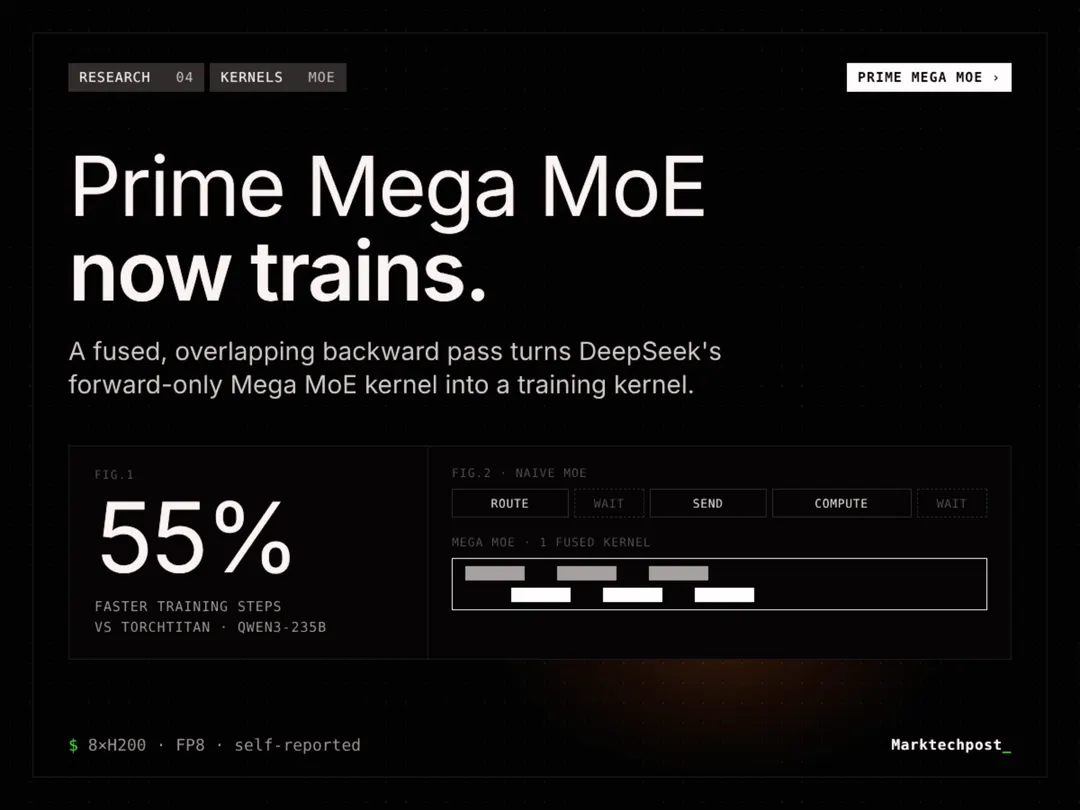
Prime Intellect расширила открытый fused-ядро Mega MoE из DeepGEMM от DeepSeek, добавив перекрывающийся backward pass для обучения. Полный шаг обучения Qwen3 MoE ускоряется на 32–34% относительно prime-rl и на 48–55% относительно TorchTitan, прямой проход — до 3,11 раза.
- Прямой проход на слое Qwen3-30B-A3B ускорен в 3,11 раза: с 12,0 до 3,9 мс
- Обратный проход на слое Qwen3-235B-A22B ускорен лишь в 1,24 раза: с 30,5 до 24,6 мс
- Пропускная способность выросла с 5 337 до 7 886 токенов/с/GPU на модели 30B
- Работает на Hopper (blockwise FP8) и Blackwell (MXFP8), а также в BF16
Читать дальше
Компании