Liquid AI выпустила LFM2.5-VL-3B-DSpark для ускорения VLM до 3,13 раза
Liquid AI представила экспериментальную draft-модель LFM2.5-VL-3B-DSpark для спекулятивного декодирования своей VLM LFM2.5-VL-3B. Драфтер добавляет около 280 млн параметров и ускоряет декодирование до 3,13 раза на Apple silicon и до 2,66 раза на Nvidia H100 без изменения вывода. Веса доступны на Hugging Face в Safetensors и GGUF с поддержкой SGLang, MLX-VLM и llama.cpp.
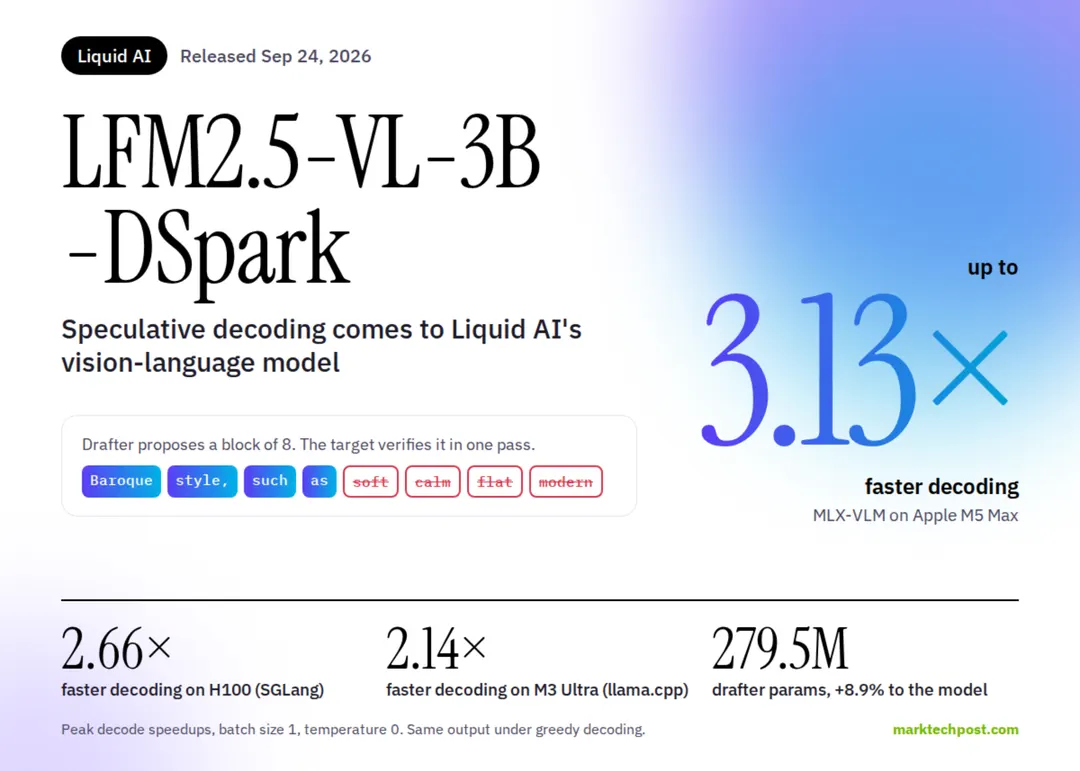
- Драфтер добавляет 279,5 млн параметров, то есть 8,9% к размеру базовой модели
- Ускорение декодирования до 3,13x на M5 Max и до 2,66x на H100
- При жадном декодировании вывод идентичен базовой модели
- Лицензия LFM Open v1.0 разрешает коммерческое использование при выручке до $10 млн
Читать дальше
ИИ