ИИ научили предсказывать насилие по видео до его начала
Исследователи Университета Алабамы обучили модель предсказывать насилие по видео до инцидента, используя мимику, звук и движения тела. Комбинация трёх сигналов дала точность 91,21% и ROC-AUC 96,38% на тестовой выборке.
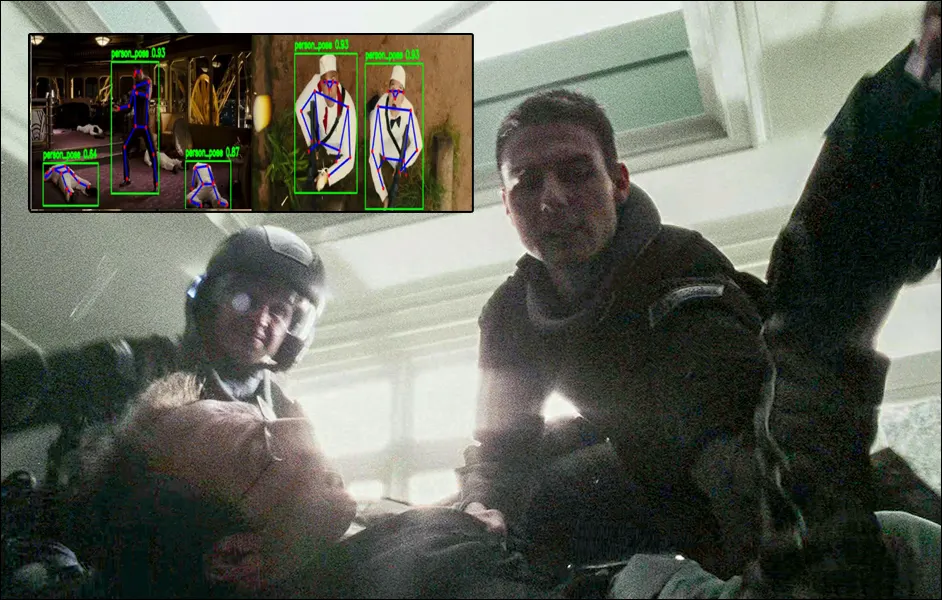
- Модель обучали только на кадрах до инцидента, а не во время него
- Точность 91,21%, F1 93,65%, ROC-AUC 96,38% при сочетании трёх сигналов
- Использованы мимика, аудио и оценка позы по датасету XD-Violence
- Анализируется до четырёх секунд видео на трёх ветках обработки
Читать дальше
ИИ