Кэш горячих экспертов ускорил 181-ГиБ модель GLM-5.3-Flash на одной GPU с 96 ГиБ
Энтузиаст запустил NVFP4-сборку GLM-5.3-Flash объёмом 181 ГиБ на одной карте RTX PRO 6000 Blackwell с 96 ГиБ памяти. Кэширование 66 самых используемых экспертов каждого слоя на GPU подняло скорость генерации до 16,5 токена/с, а группировка экспертов по 64 ускорила чтение промпта с 614 до ~1750 токенов/с.
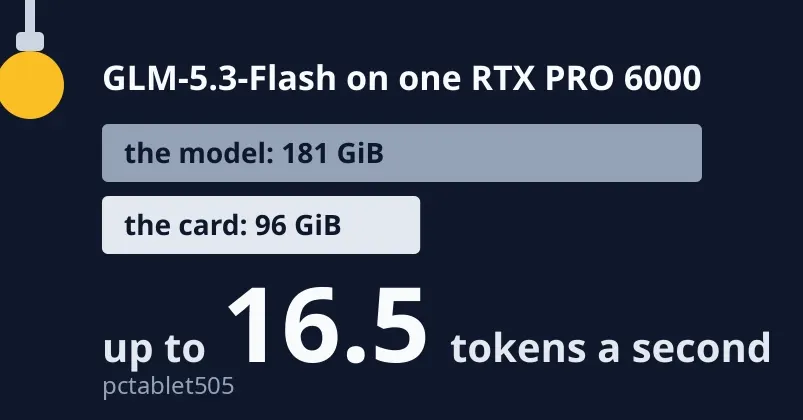
- Генерация: 16,5 токена/с с 66 горячими экспертами на карте против 14,99 в штатном режиме
- Чтение промпта выросло с 614 до ~1750 токенов/с при обходе экспертов группами по 64
- Промпт на 304 800 токенов обработан за 205 с — 93% от лимита 327 680
- Отключение 2 из 8 экспертов дало 20,48 токена/с, но вывод зациклился
Читать дальше
ИИ