TokenGate от Stanford и UC Berkeley ускоряет prefill длинного контекста до 11,3 раза
Исследователи Stanford и UC Berkeley представили TokenGate — модуль обученного прунинга токенов для LLM. Он ускоряет время до первого токена в 1,4–11,3 раза и снижает пиковую память prefill в 1,5–3,4 раза без потери точности. Код и чекпоинты выложены на GitHub под Apache-2.0.
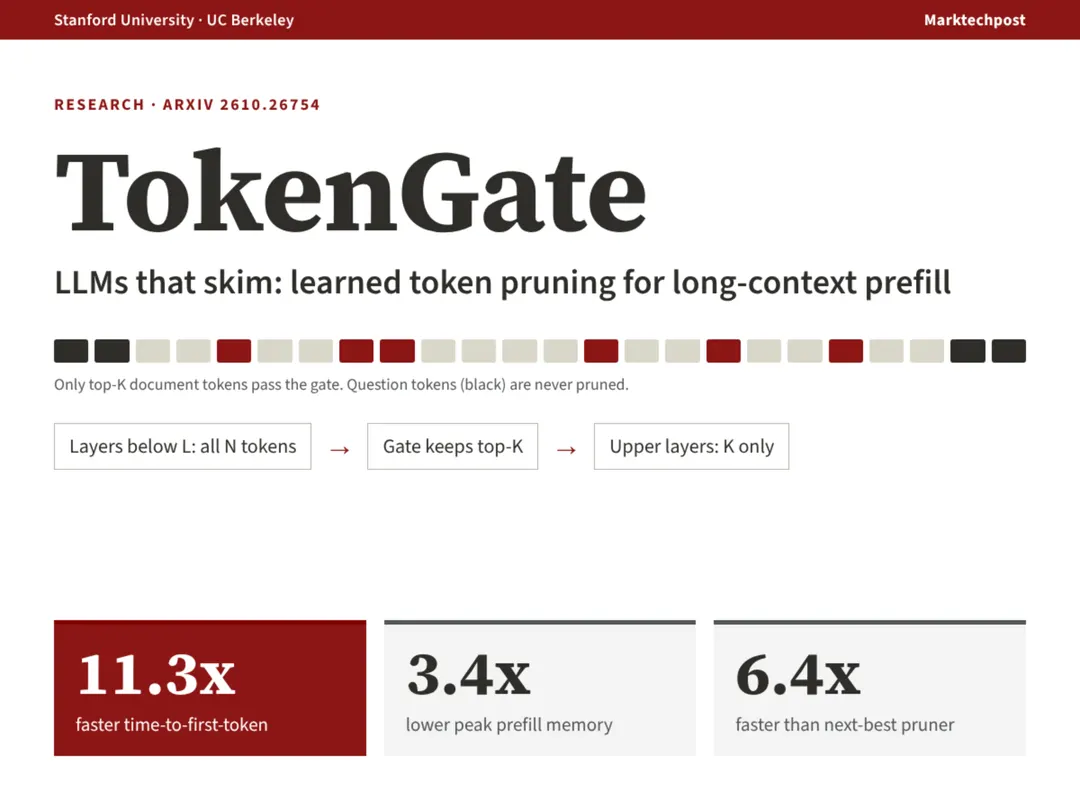
- TTFT быстрее в 1,4–11,3 раза, пиковая память ниже в 1,5–3,4 раза
- На NIAH 16k — 11,3 раза быстрее и в 3,42 раза меньше памяти
- На контексте 128k ускорение TTFT достигает 13,0 раза
- Тесты на Qwen3-1.7B и Qwen3.5-2B, контексты до 128k токенов
Читать дальше
Железо