GPUStack ускорила инференс GLM-5.3-Flash на четырёх DGX Spark в 2,11 раза
Кластер из четырёх NVIDIA DGX Spark под управлением GPUStack и vLLM разогнал однопоточное декодирование GLM-5.3-Flash-NVFP4 с 24,3 до 51,3 ток/с. Настройка сети RoCE и NCCL подняла пропускную способность AllReduce с 4,0 до 22,9 ГБ/с, а агрегатная пропускная способность при четырёх запросах выросла с 72,0 до 104,1 ток/с.
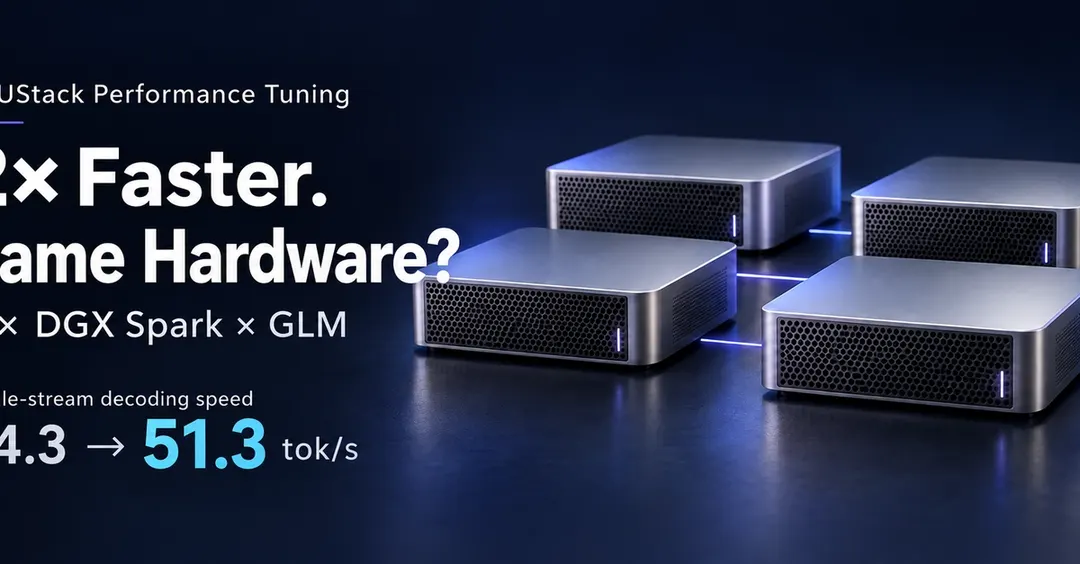
- Однопоточное декодирование выросло с 24,3 до 51,3 ток/с (2,11×)
- AllReduce на 256 МБ ускорился с 4,0 до 22,9 ГБ/с (около 5,7×)
- Агрегатная пропускная способность при 4 запросах: с 72,0 до 104,1 ток/с
- TP=4 на четырёх узлах с 128 ГБ памяти и ConnectX-7
Читать дальше
ИИ